Komisja Europejska nakazała Google udostępniać dane wyszukiwań wszystkich Europejczyków. Przekazywać innym firmom, np. twórcom chatbotów AI (np. gdy ktoś sobie założy startup i będzie chciał dane), albo konkurencyjnym wyszukiwarkom. Z powodów polityki konkurencyjności. W dużym uproszczeniu w ramach tego planiu to takie kopiuj-wklej danych użytkowników Google (być może Twoich), czyli tego, co użytkownik wpisuje w wyszukiwarkę Google. Z pewnym krokiem „anonimizacji”. Przetestowałem tę warstwę na prawdziwych danych Google (to setki miliardów wyszukiwań, skala petabajtów). Złamałem ją.
Pełen raport: Alone among a thousand.
Komisja Europejska wydała wobec Google decyzję na podstawie Digital Markets Act (akt o rynkach cyfrowych, DMA). W kwietniu krytycznie oceniałem poprzednią wersję tego schematu: niosła poważne ryzyka dla prywatności, a nawet dla bezpieczeństwa narodowego. Zrobiłem to sam z siebie, bez dostępu do danych. We wrześniu tego roku Google poprosił mnie o audyt schematu KE i danych udostępnianych na podstawie decyzji DMA. Zacząłem w październiku. Efektem jest ten raport.
Tłum tysiąca
Wg. planów Komisji Europejskiej, użytkownicy mają być ukryci w tłumie innych. W schemacie Komisji dane wyszukiwania mają być przekazywane tak, by nie dało się rozpoznać pojedynczych wyszukiwań pośród innych. Grupowanie takie opiera się na metadanych: dzień, lokalizacja (np. Warszawa, Poznań), typ urządzenia (np. komputer, telefon), język wyszukiwania. Dane zawierają znacznik lokalizacji gdy co min. 1000 zalogowanych użytkowników wyszukuje czegoś tego samego dnia, w tym samym języku i na tym samym typie urządzenia. Jeśli nie, to dane geograficzne zastępuje się ogólniej, krajem (np. „Belgia”), a jeśli i ta grupa jest za mała, wyszukiwanie jest usuwane. Komisja twierdzi, że dzięki temu użytkownicy są „nie do odróżnienia od siebie”. Sprawdziłem to i znalazłem sposoby, by tę zasadę przełamać.
Problem polega na tym, że schemat uwzględnia język, w którym użytkownicy szukają, ale nie język wyświetlania - czyli język ustawiony w przeglądarce internetowej, zapewne jako ustawienie znacznie trwalsze niż język wyszukiwania (ile razy w ostatnich 5 latach zmienialiście to ustawienie? a swoje położenie?). A dane zawierają oba te sygnały. Schemat uogólniania bierze pod uwagę tylko jeden.
Oto jeden przykład, bezpośrednio z danych.
1 sierpnia ktoś w okręgu Liège w Belgii szukał po angielsku na telefonie z Google wyświetlanym w j filipińskim. To było jedyne takie wyszukiwanie wśród 92 990 zapisów. Użytkownik został wyróżniony jednoznacznie.
Tak wyróżnionych "z tłumu" osób jest dużo więcej. I nie chodzi tylko o języki spoza Europy.
Przykładowo, osoba szukająca w j niemieckim z językiem wyświetlanym po rumuńsku była sama wśród 479 463 zapisów w powiecie Oberallgäu w Bawarii.
Wyszukiwanie w j polskim z ustawieniem języka wyświetlanym po węgiersku było jedyne takie wśród 2,2 mln w powiecie kaliskim.
Po francusku z ustawieniem w j włoskim - wśród 1,7 mln w departamencie Eure we Francji, a po francusku z ustawieniem językowym na polski - wśród 125 524 w okręgu Verviers w Belgii.
Oczywiście im rzadszy język ustawiony w przeglądarce, tym większe ryzyko. Komisja Europejska o tym wie - sama to odnotowała w pierwszej decyzji z lipca.
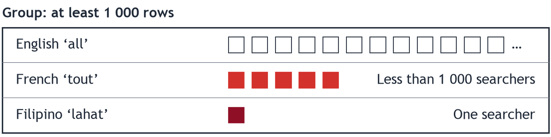
Przeanalizowałem to systematycznie i na dużą skalę. W podobny sposób wyłuskałem z tłumu osoby stojące za pół miliona wyszukiwań, i to tylko dla kilku krajów w jednym miesiącu (sierpień 2026). Problem jest na pewno większy. Wobec samych 26 mld wszystkich sierpniowych wyszukiwań w Belgii, Francji, Polsce i Niemczech może to wyglądać na niewielki ułamek, ale żeby anonimizacja działała, to musi działać dla wszystkich. Potwierdza to Europejska Rada Ochrony Danych (EDPB). „Singled out” oznacza tu, że ktoś jest sam w tłumie. Można go i jego akcje jednoznacznie zidentyfikować, a RODO potwierdza, że to identyfikacja osoby.
Problem jest tu bezpośredniy i niezaprzeczalny. Formalnie oznacza to, że ta anonimizacja pozwala izolować pojedyncze rekordy w bazie danych.
Trzy wyszukiwania
Komisja Europejska przewiduje też, by historię wyszukiwań pocięto na kawałki - po trzy. Czyli przypisuje się akcji użytkownika maksymalnie trzy wyszukiwania, powiązane jednym identyfikatorem (mini-session ID). Komisja twierdzi, że przeprowadziła własne eksperymenty i kawałków nie da się połączyć.
Połączyłem je ponad ten limit trzech. Wychodząc od opisanych wcześniej osób, które były same w tłumie, połączyłem kawałki w ponad 200 tys. zestawów dłuższych niż trzy wyszukiwania - i to tylko dla Niemiec i tylko w sierpniu.
Łączenie działa jeszcze lepiej przy treściach specjalistycznych. Oto przykład (syntetyczny) modelowany na tym, co zawierają dane. Wyobraźmy sobie osobę, która najpierw szuka informacji o guzie mózgu, potem o operacji mózgu i rekonwalescencji, a na końcu o neurochirurgu w konkretnym mieście. Każdy kawałek zdradza niewiele, ale razem czyta się je jak kartotekę pacjenta.
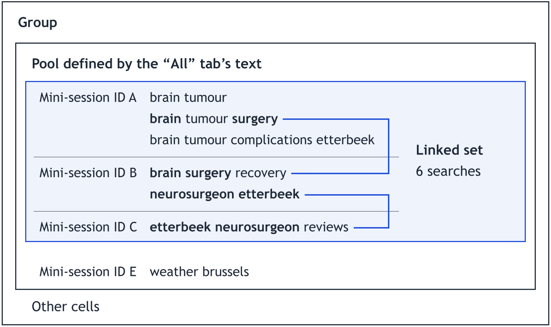
W swej decyzji Komisja Europejska przekonuje, że tekst wyszukiwania „nie jest jak karta pacjenta z diagnozą”, bo wyszukiwanie może dotyczyć kogoś innego. Jedno wyszukiwanie? Może i tak. Ale gdy ta sama choroba czy wynik diagnostyczny pojawiają się w kilku połączonych kawałkach to dużo trudniej tak twierdzić. Chyba, że się nie sprawdziło. Ja sprawdziłem. W mniej więcej co piątym zestawie danych tak połączonym były informacje medyczne lub prywatne, których nie było w żadnym pojedynczym kawałku. W ten sposób można też łączyć wyszukiwania użytkownika z różnych urządzeń, np. tych robionych z telefonu, a później z komputera. Formalnie nazywa się to linkage (łączenie).
Wnioskowanie
Potwierdzam też, że na tych danych można prowadzić wnioskowanie (inference). Wnioskowanie oznacza ustalenie o kimś czegoś, czego ta osoba nigdy nie napisała wprost. Lub napisała, ale w kilku rekordach danych, a jako całość daje to jeszcze więcej informacji. W przykładzie powyżej nikt nie wpisał „mam guza mózgu”. Ale z połączonych wyszukiwań widać to wyraźnie. Zwłaszcza w połączonych wyszukiwaniach takie łączenie daje więcej informacji niż jakiekolwiek pojedyncze wyszukiwanie. Takie wrażliwe informacje pojawiały się 3-5 razy częściej w połączonych wyszukiwaniach niż w pojedynczym kawałku (mini-session, najwyżej 3 wyszukiwania).
Do wnioskowania użyłem AI, na dużą skalę. Udało mi się wydobyć informacje dotyczące zdrowia, religijności, poglądów politycznych, zainteresowań seksualnych (itp), treściami dla dorosłych i innych. To wrażliwe kategorie, które RODO chroni najmocniej.
Teraz zmiana tematu
Ramstein, Mons, Powidz, Poznań, Genewa
Prywatność to tylko część problemu. Dane do udostępnienia obejmują wrażliwe miejsca, np. okolice baz wojskowych. W Europie to Ramstein, Mons, Powidz czy Poznań, gdzie z rodzinami mieszkają żołnierze USA i NATO. Także Genewa, gdzie mieszkają i pracują dyplomaci i pracownicy organizacji międzynarodowych. Wokół każdej z tych baz znalazłem wyszukiwania, które łączą oznaki służby wojskowej z np. problemami zdrowotnymi, alkoholem lub narkotykami, albo kłopotami dyscyplinarnymi. Można sobie wyobrazić, że to ryzyko kontrwywiadowcze. To są te okoliczności osobiste, których szukają postępowania sprawdzające, bo można je wykorzystać przeciwko danej osobie.
W Genewie wyszukiwania wskazują na pracowników organizacji międzynarodowych i misji dyplomatycznych oraz na osoby, których oni wyszukują. To nie są po prostu przypadkowe nazwiska wpisane w wyszukiwarkę, bo dane do udostępnienia precyzyjnie identyfikowały te osoby.
Wreszcie znalazłem też wyszukiwania osoby, która poważnie rozważała pracę w organizacji wywiadowczej jednego z państw UE. Szczegóły tego konkretnego wyszukiwania, razem z informacjami dostępnymi publicznie, zawęziły krąg do kilku możliwych, zidentyfikowanych osób - zamiast obiecanego tłumu tysiąca.
Główne obserwacje w tym przypadku zajęły mi jeden dzień. Nie trzeba dodawać, że obcy wywiad ma więcej czasu i zasobów.
Do punktu wyjścia
Motywacje polityki konkurencyjnej i DMA mogą być słuszne. Ale co z realizacją? Udostępnianie danych w formie obecnie żądanej stanowiłoby duży problemem. Schemat ten nie zapewnia anonimowości. Udostępnione zostałyby dane osobowe.
Udostępnienie ich zgodnie z obecnym projektem mogłoby skończyć się dużym wyciekiem danych osobowych na skalę europejską.
W ramach tej pracy wykazuję też, że proponowane obecnie wytyczne EDPB w sprawie anonimizacji trzeba poprawić. Ich projekt jest niewystarczający bo uwzględnia tylko łączenie zapisów między osobnymi bazami danych, a nie wewnątrz jednej. Tutaj jednoznacznie dowodzę, że łączenie w obrębie tej samej bazy danych może być problemem i łamać anonimizację. Co ciekawe, Grupa Robocza Art. 29 (Working Party 29) w 2014 r., jeszcze przed RODO, słusznie to przewidywała i uwzględniała. Trudno powiedzieć, co stało się w międzyczasie, ale moja praca to szansa na korektę kursu.
Anonimizacja to właściwość danych. Trzeba to więc sprawdzać w praktyce.
Dla pełnej jasności. Google zleciło mi tę analizę i ją sfinansowało. Poświęciłem na to dużo mojego czasu. Miałem pełną niezależność. Google nie ingerowało w mą pracę i mogło sprawdzić tekst tylko pod kątem zawarcia w niej danych osobowych. Dodam tu, że wcześniej byłem krytyczny wobec niektórych działań Google. Na ryzyka opisane w tym wpisie zwracałem uwagę np. w kwietniu, to jeszcze na podstawie projektu schematu, zanim widziałem jakiekolwiek dane. Teraz zmierzyłem to na wersji ostatecznej.
Jest też dla mnie jasne, że AI zmienia założenia, na których od lat opiera się ochrona danych. To już rzeczywistość, nie przyszłość. Gdy takie dane zostaną raz udostępnione, będzie można zastosować do nich także przyszłe techniki.
Na szczęście RODO jest na to gotowe. Uwzględnia rozwój technologii i stan techniki (state of the art). W tym przypadku aktualnym to ja jestem aktualnym stanem wiedzy i techniki.
Pracuję jako niezależny badacz i konsultant w dziedzinie cyberbezpieczeństwa i prywatności. Pytania, komentarze, a może oferty? Email: me@lukaszolejnik.com. Pełny raport: Alone among a thousand.
Comments is loading...